AI资讯新闻榜单内容搜索-NeurIPS

AITNT-国内领先的一站式人工智能新闻资讯网站
# 热门搜索 #
搜索: NeurIPS
NeurIPS 2026|不再依赖外挂:清华把「自我进化技能」训进Agent大脑

NeurIPS 2026|不再依赖外挂:清华把「自我进化技能」训进Agent大脑

NeurIPS 2026|不再依赖外挂:清华把「自我进化技能」训进Agent大脑

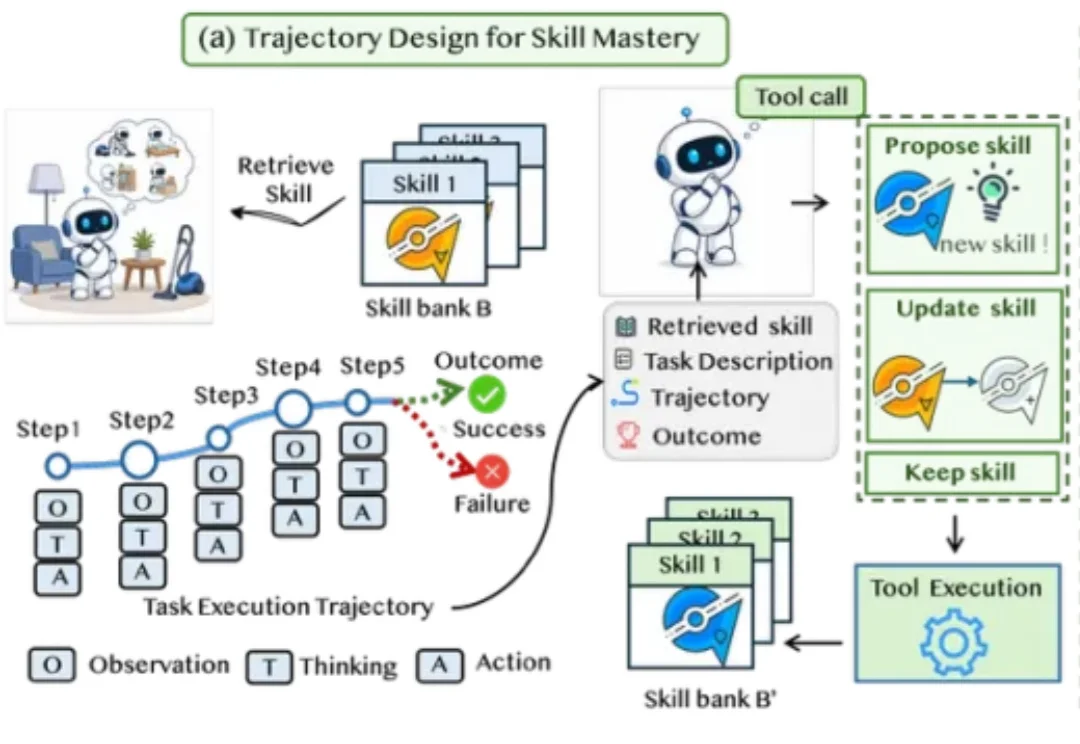
随着递归自我改进(Recursive Self-Improvement,RSI)研究的兴起,智能体的长期能力演进受到更多关注。技能(Skill)能够将交互经验提炼为可复用的操作流程与任务策略,使一次任务的收获服务于后续任务。让智能体学会自主创建和改进这些技能,为其持续进化提供了一条具体路径。

来自主题: AI技术研报
8545 点击    2026-11-16 15:13
NeurIPS 2026|扩散模型和自回归模型谁的隐私泄露更多? 奥尔堡大学揭示扩散语言模型的记忆行为

NeurIPS 2026|扩散模型和自回归模型谁的隐私泄露更多? 奥尔堡大学揭示扩散语言模型的记忆行为

NeurIPS 2026|扩散模型和自回归模型谁的隐私泄露更多? 奥尔堡大学揭示扩散语言模型的记忆行为

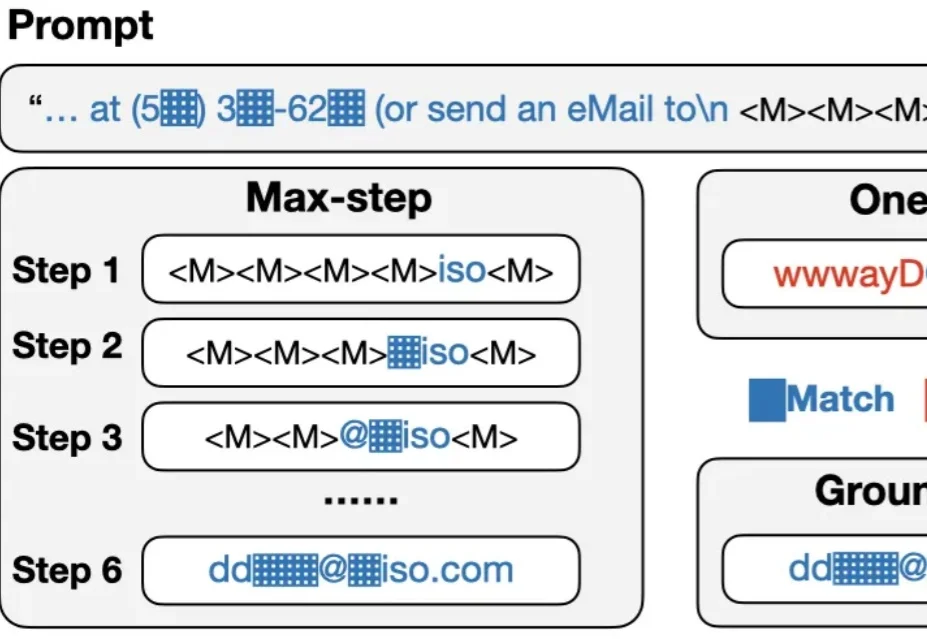
大语言模型有时会把训练时见过的内容原样「背出来」,其中可能包含邮箱、电话号码等个人信息。随着扩散语言模型走向更大规模,一个问题也随之出现:当模型不再从左到右逐词生成,它还会以同样的方式泄露训练数据吗?

来自主题: AI技术研报
6985 点击    2026-11-16 15:12
NeurIPS 2026|AI搜索时搜到的图,为什么用不了?港科大给每张图编了号

NeurIPS 2026|AI搜索时搜到的图,为什么用不了?港科大给每张图编了号

NeurIPS 2026|AI搜索时搜到的图,为什么用不了?港科大给每张图编了号

香港科技大学 MMSense Lab 的 Visual-Native Agent Harness 通过为图片编号实现跨工具复用,并提出 On-policy Data Evolution(ODE)按 rollout 动态调整出题规则,使 8B 模型八项评测平均准确率从 24.9% 升至 39.0%,该工作获 NeurIPS 2026 接收。

来自主题: AI技术研报
7875 点击    2026-11-14 12:44
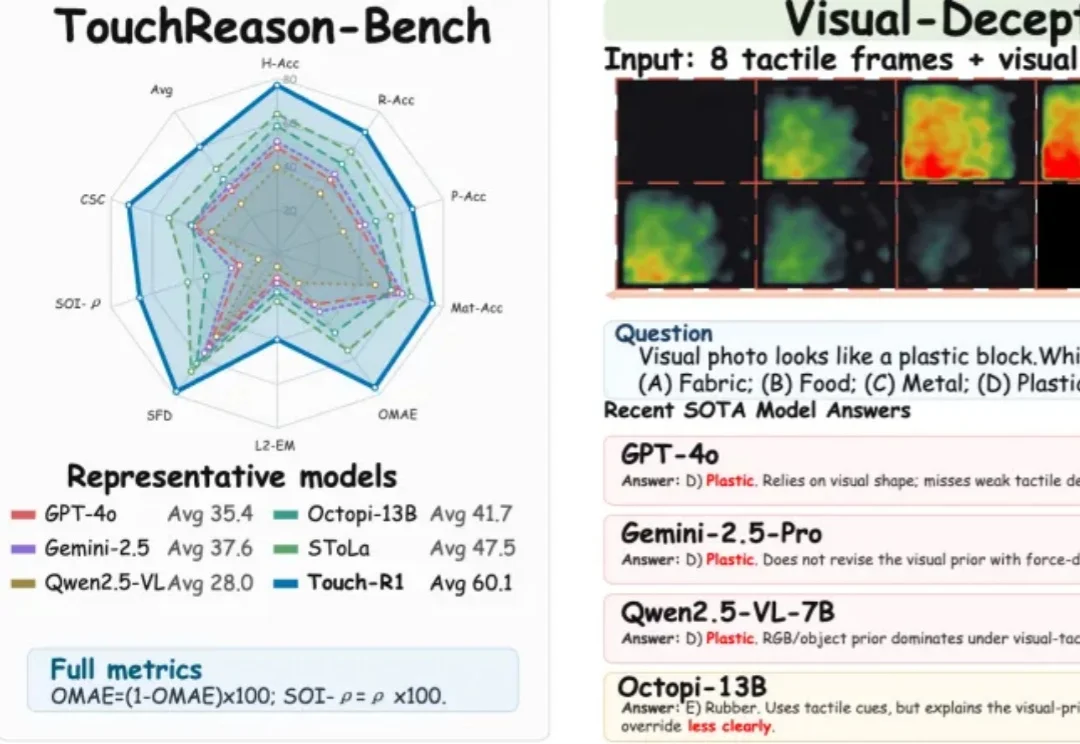
让AI「摸懂」物理世界,首个触觉推理模型Touch-R1,入选NeurIPS 2026

让AI「摸懂」物理世界,首个触觉推理模型Touch-R1,入选NeurIPS 2026

让AI「摸懂」物理世界,首个触觉推理模型Touch-R1,入选NeurIPS 2026

看起来像硬质塑料,按下去却十分柔软 —— 当视觉与触觉发生冲突,人类往往会依赖触感修正视觉误区;但现有的多模态模型却常常更相信视觉,从而误判物体的真实物理属性。

来自主题: AI技术研报
8885 点击    2026-11-10 09:02
NeurIPS 2026 | 国产昇腾大模型RL训练系统,最高提速222%

NeurIPS 2026 | 国产昇腾大模型RL训练系统,最高提速222%

NeurIPS 2026 | 国产昇腾大模型RL训练系统,最高提速222%

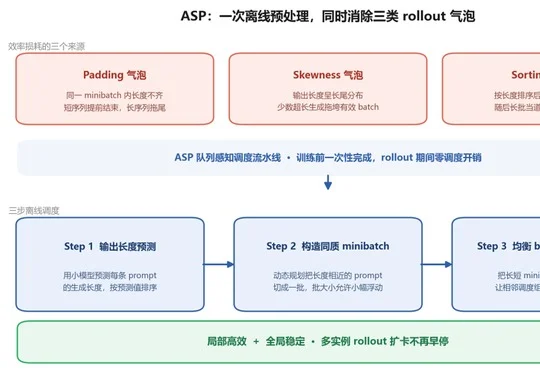
深圳市大数据研究院与华为联合研发的ASP被NeurIPS 2026接收,该系统基于昇腾910B3和MindSpeed-RL,以队列感知调度优化多实例异步RL训练,生成吞吐最高提升222%、单轮迭代时间最多降低76%,并将电信百卡集群训练周期从3个多月缩短至约2个月。

来自主题: AI技术研报
8981 点击    2026-11-07 14:47
NeurIPS 2026 | 从「先出题」到「先探索」:重新思考Tool-Calling Agent的训练数据合成

NeurIPS 2026 | 从「先出题」到「先探索」:重新思考Tool-Calling Agent的训练数据合成

NeurIPS 2026 | 从「先出题」到「先探索」:重新思考Tool-Calling Agent的训练数据合成

Firefly 在 NeurIPS 2026 提出“先探索、后出题”的训练数据合成流程,利用真实 MCP Server 和可离线复现的检索增强模拟器生成5,144个可验证任务,使 Qwen3-4B-Thinking-2507 的 pass@1 从28.1%升至41.5%。

来自主题: AI技术研报
8711 点击    2026-11-07 14:47
NeurIPS'26 | 如何减少共情推理中的错误传播?

NeurIPS'26 | 如何减少共情推理中的错误传播?

NeurIPS'26 | 如何减少共情推理中的错误传播?

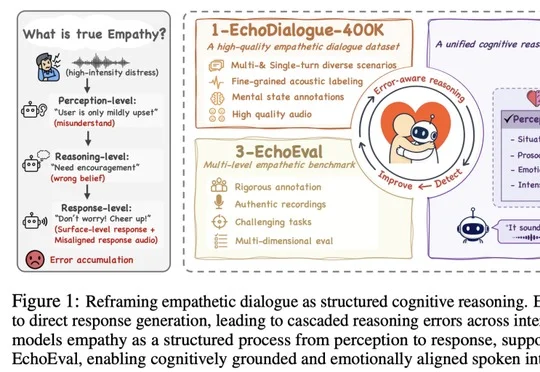
香港中文大学与微软团队提出EchoChat,将感知、心理状态推断与语音回复生成纳入统一优化框架,通过级联门控、SDCA步骤级信用分配和AAA声学注意力约束减少共情推理中的错误传播,相关成果发表于NeurIPS 2026,并发布EchoDialogue-400K数据集与EchoEval评测。

来自主题: AI技术研报
10262 点击    2026-11-07 14:46
NeurIPS 2026 | 港大提出RaPO:强化微调破解MLLM灾难性遗忘,代码已开源

NeurIPS 2026 | 港大提出RaPO:强化微调破解MLLM灾难性遗忘,代码已开源

NeurIPS 2026 | 港大提出RaPO:强化微调破解MLLM灾难性遗忘,代码已开源

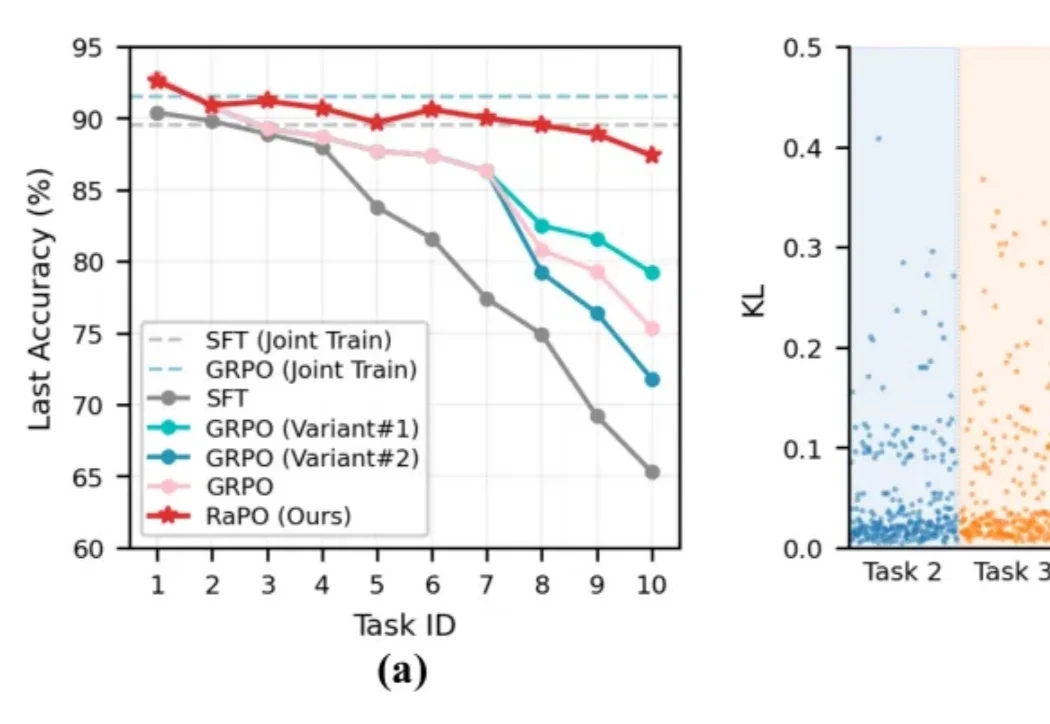
在 LLM/MLLM 领域,基于 verifier 奖励的强化微调(Reinforcement Fine-Tuning, RFT,如 GRPO)在激发复杂推理能力方面展现出显著优势。由于 On-policy 优化的特性,很多研究指出 RFT 相比传统的监督微调(SFT)天然具备更强的抗遗忘能力。

来自主题: AI技术研报
8973 点击    2026-11-05 17:01